PRIVACY / SICUREZZA & CULTURA DIGITALE

BESEF / CONSAPEVOLEZZA

Il cavallo di Troia che abbiamo in tasca

Dall’automobile allo smartphone: perché imparare a riconoscere i rischi digitali è diventato necessario.

PARTE 01 — RICONOSCERE I PERICOLI
Quando una grande invenzione cambia le regole del gioco

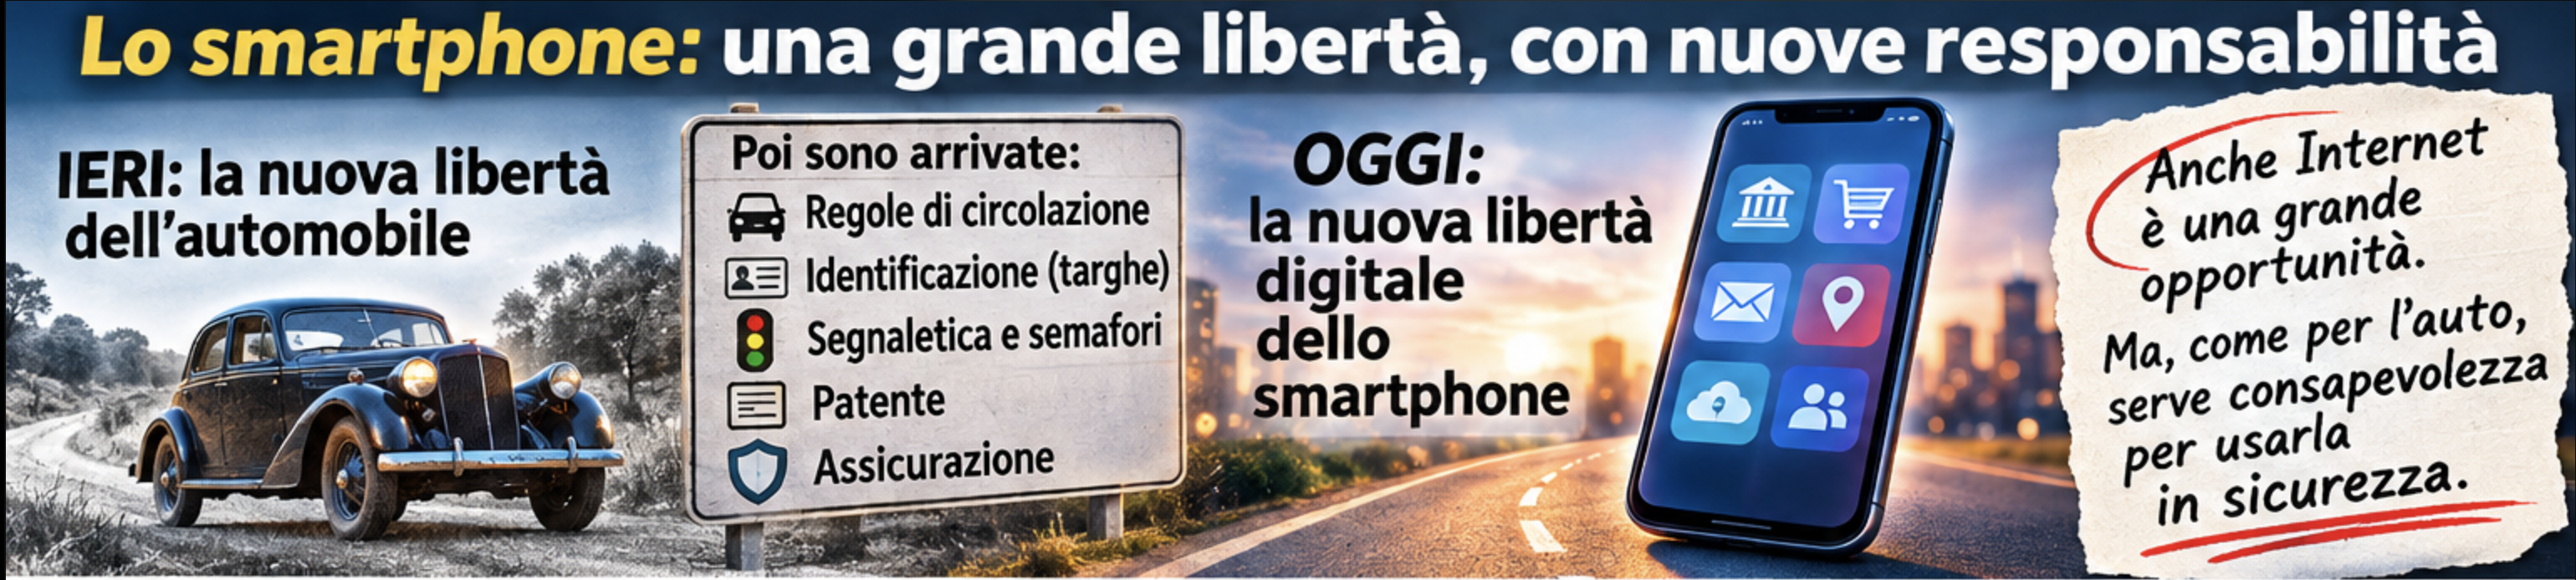
Immaginiamo di tornare indietro di oltre un secolo, ai tempi delle prime automobili.

Le strade erano percorse prevalentemente da pedoni, carrozze, cavalli e biciclette. Le automobili rappresentavano una novità straordinaria, un’invenzione destinata a cambiare profondamente il modo di vivere e di spostarsi.

All’inizio erano poche, costose, complicate da utilizzare e accessibili soltanto a una parte limitata della popolazione.

Con il passare degli anni, però, le automobili diventarono sempre più diffuse.

E con la loro diffusione emerse qualcosa che inizialmente non era stato possibile prevedere in tutte le sue conseguenze: non bastava più costruire automobili capaci di muoversi. Bisognava imparare a convivere con esse.

Le strade dovevano adattarsi, il traffico doveva essere regolamentato, i conducenti dovevano essere identificabili e gli incidenti dovevano essere prevenuti e gestiti.

Si svilupparono progressivamente sistemi di immatricolazione, targhe, segnaletica, semafori, norme di circolazione, patenti di guida e assicurazioni.

Non tutte queste innovazioni arrivarono nello stesso momento o nello stesso ordine nei diversi Paesi. Furono il risultato di un lungo processo di adattamento tecnologico, sociale e normativo.

Eppure oggi ci sembrano assolutamente naturali.

Nessuno si stupisce che per guidare un’automobile, una moto, un camion sia necessario conoscere il significato dei segnali stradali, rispettare le precedenze, comprendere i limiti di velocità o avere una o più patenti ed una copertura assicurativa.

Non consideriamo queste conoscenze una specializzazione riservata agli ingegneri automobilistici ma una conoscenza diffusa.

Sono oggi parte della preparazione necessaria per utilizzare responsabilmente un mezzo che è entrato nella vita quotidiana di milioni di persone.

E soprattutto abbiamo imparato che la sicurezza stradale non dipende esclusivamente dalla qualità dell’automobile.

Un veicolo può avere freni eccellenti, airbag, sistemi elettronici di stabilità e sensori di ogni genere. Ma se chi lo guida non conosce le regole, ignora i segnali o sottovaluta una situazione pericolosa, tutte quelle tecnologie potrebbero non bastare.

L’automobile è diventata sempre più sicura, ma il comportamento del conducente continua ad avere un ruolo fondamentale.

Ora proviamo a trasferire questo ragionamento a un’altra tecnologia che ha trasformato la nostra moderna società.

Una tecnologia che, in pochi decenni, è entrata nelle case, nelle tasche e nelle abitudini di miliardi di persone.

Internet. E soprattutto lo smartphone.

Una rivoluzione senza patente

Per guidare un’automobile, nel 2026, dobbiamo dimostrare di conoscere almeno 10 tipologie di regole fondamentali della circolazione.

Esempio:

Area di studioArgomenti principali
1. SegnaleticaSegnali di pericolo, divieto, obbligo, precedenza, indicazione e segnaletica orizzontale.
2. Regole di circolazionePrecedenze, incroci, semafori, sorpassi, svolte, fermata e sosta.
3. Velocità e distanzeLimiti di velocità, distanza di sicurezza, spazi di frenata e condizioni stradali.
4. Sicurezza del veicoloCinture, airbag, seggiolini, pneumatici, freni, luci e dispositivi di sicurezza.
5. Conoscenza del mezzoElementi di meccanica, manutenzione, controlli e spie del cruscotto.
6. Comportamento del conducenteAttenzione, stanchezza, tempi di reazione, alcol, droghe e farmaci.
7. Incidenti e primo soccorsoPrevenzione, comportamento in caso di incidente e assistenza agli infortunati.
8. Responsabilità e documentiPatente, assicurazione RCA, sanzioni e responsabilità civile e penale.
9. Rispetto degli altriPedoni, ciclisti, utenti vulnerabili e comportamento corretto sulla strada.
10. AmbienteConsumi, emissioni, inquinamento e guida rispettosa dell’ambiente.

Per utilizzare uno smartphone, invece, non è richiesta alcuna preparazione.

Basta acquistarlo, accenderlo, seguire alcune istruzioni e cominciare.

Naturalmente non sto suggerendo di introdurre una patente per Internet. Il paragone serve a evidenziare una differenza importante nel modo in cui affrontiamo due tecnologie ormai indispensabili.

Nel mondo automobilistico abbiamo progressivamente riconosciuto che la diffusione di uno strumento richiede anche educazione specifica, regole e consapevolezza.

Nel mondo digitale, invece, abbiamo privilegiato soprattutto la semplicità e la rapidità di accesso.

E questo ha prodotto un fenomeno curioso.

Possiamo utilizzare quotidianamente servizi bancari, effettuare pagamenti, gestire documenti personali, comunicare informazioni riservate e autorizzare operazioni importanti senza sapere quasi nulla dei meccanismi tecnologici che rendono possibili queste attività.

Non è necessario conoscere il funzionamento di un motore per guidare un’automobile. Allo stesso modo, non serve conoscere i protocolli di rete o la crittografia per utilizzare Internet.

Ma così come un automobilista dovrebbe sapere cosa significa una spia rossa sul cruscotto, chi utilizza Internet dovrebbe imparare a riconoscere alcuni segnali di pericolo.

Un indirizzo sospetto, una richiesta insolita di credenziali, un messaggio che pretende una risposta immediata, un’applicazione che richiede autorizzazioni apparentemente ingiustificate.

Sono, in un certo senso, i segnali stradali della nostra vita digitale.

Il problema è che molti di noi non hanno mai imparato a leggerli.

E spesso non sappiamo nemmeno che esistono.


Un oggetto, mille responsabilità

Proviamo a pensare a una giornata qualsiasi.

Ci svegliamo e controlliamo il telefono. Leggiamo i messaggi, guardiamo le notizie, consultiamo il meteo. Magari paghiamo un caffè, acquistiamo un biglietto, controlliamo il conto corrente o riceviamo un codice per accedere a un servizio.

Durante il giorno fotografiamo, condividiamo, cerchiamo informazioni, utilizziamo il navigatore. La sera magari prenotiamo una visita medica, facciamo un acquisto, prenotiamo una vacanza o scambiamo documenti con qualcuno.

Tutto attraverso lo stesso dispositivo.

Lo smartphone è diventato contemporaneamente il nostro portafoglio, la nostra agenda, il nostro archivio personale, uno strumento di comunicazione e una delle principali chiavi della nostra identità digitale.

Un oggetto straordinario, indubbiamente. Ma proprio questa concentrazione di funzioni dovrebbe portarci a una riflessione.

Quanto sappiamo davvero di ciò che accade quando tocchiamo lo schermo?

La tecnologia ha compiuto un’impresa eccezionale: rendere operazioni estremamente complesse accessibili praticamente a chiunque.

Un bambino, una persona anziana o un esperto informatico possono utilizzare le stesse applicazioni, spesso senza percepire alcuna differenza.

Ma c’è un paradosso.

La tecnologia è diventata universale. La conoscenza dei suoi rischi, invece, non lo è.

E questa distanza tra facilità d’uso e comprensione dei meccanismi rappresenta uno dei punti deboli della nostra vita digitale.
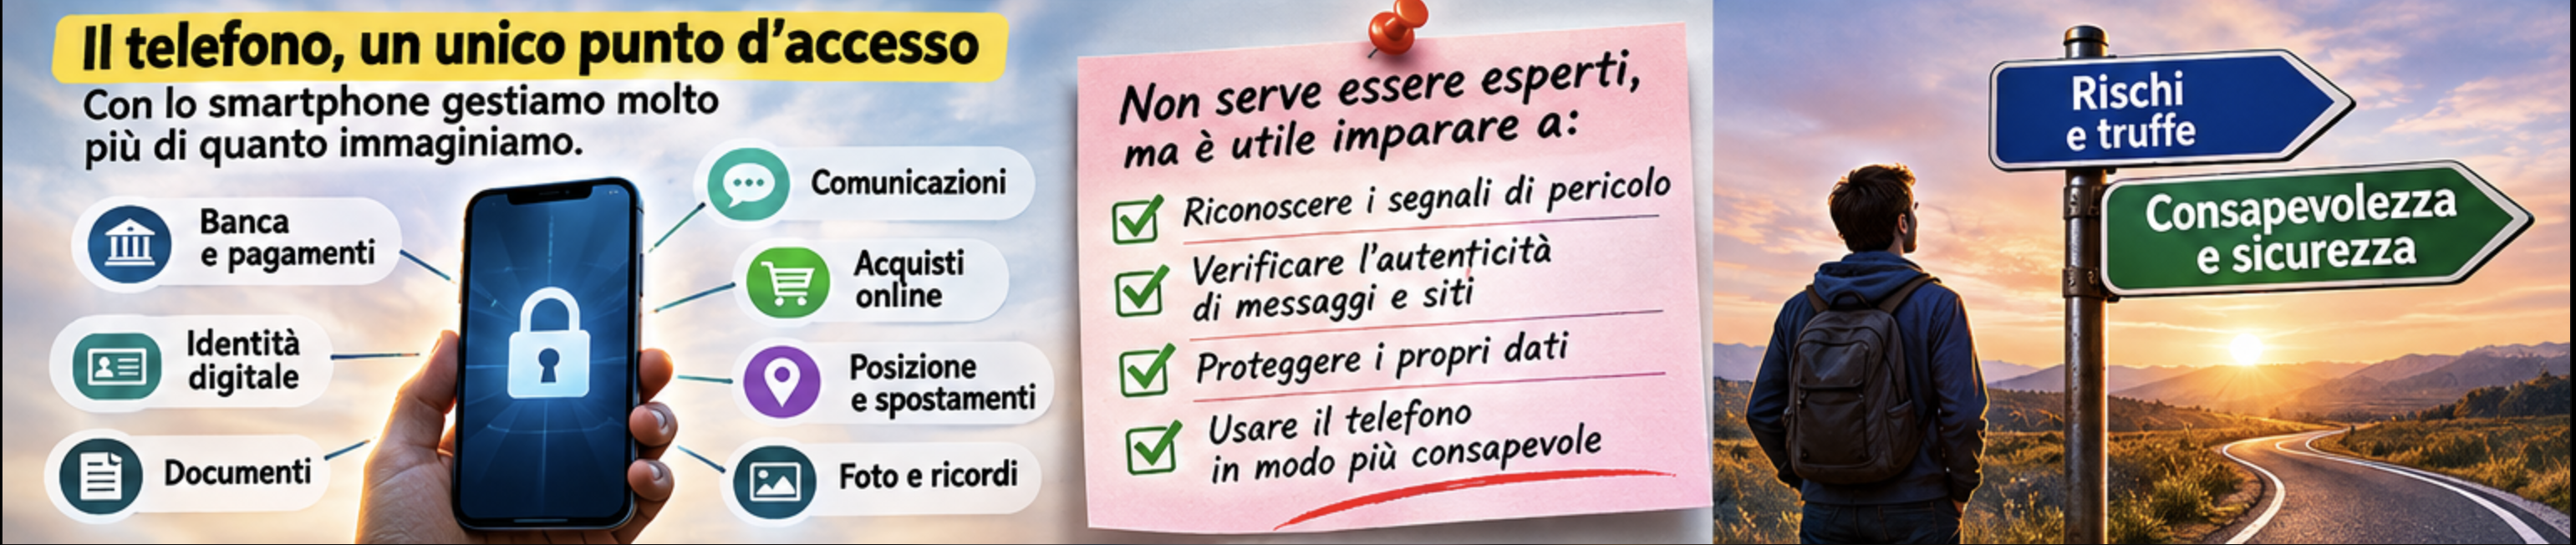
Il cavallo di Troia moderno

Quando sentiamo parlare di attacchi informatici, immaginiamo spesso un hacker davanti a numerosi monitor, impegnato a violare sistemi attraverso sofisticate competenze tecniche.

È un’immagine cinematografica che racconta soltanto una presunta realtà romantica, che cerca di raffigurare “l’uomo nero” delle fiabe, usate per spaventare i bambini.

Molti attacchi non hanno bisogno neppure di superare complesse protezioni informatiche. Cercano piuttosto di convincere una persona a compiere spontaneamente un’azione: aprire un collegamento, comunicare una password, autorizzare un pagamento, installare un’applicazione.

In altre parole, non sempre è necessario forzare una porta quando si può convincere qualcuno ad aprirla.
( “un sistema è forte quanto il suo anello più debole” )

Ed è qui che lo smartphone assume un ruolo centrale.

Lo portiamo sempre con noi. Lo consultiamo decine di volte al giorno, spesso distrattamente, mentre camminiamo, lavoriamo, viaggiamo o facciamo altro.

Riceviamo continuamente notifiche e richieste di attenzione. Ci abituiamo a rispondere rapidamente, a confermare, ad accettare, a premere << Continua >>.

Questa familiarità crea FIDUCIA.

Ma la fiducia, quando diventa automatica, senza alcuna verifica, può trasformarsi in una vulnerabilità.

Lo smartphone non è necessariamente un dispositivo insicuro. Anzi, i moderni sistemi operativi dispongono di numerose protezioni sofisticate.

Il problema è che anche un dispositivo ben protetto può diventare il punto d’incontro tra una persona, un messaggio ingannevole e una decisione sbagliata.

Il nostro cavallo di Troia non è quindi soltanto tecnologico: è anche psicologico.

E non riguarda esclusivamente chi ha poche conoscenze informatiche.

Anche una persona esperta può essere ingannata quando è distratta, stanca, preoccupata o semplicemente convinta di trovarsi in un ambiente affidabile.

Le competenze riducono i rischi, ma non rendono invulnerabili.


Quando basta una lettera: il typosquatting
Immaginiamo di dover accedere al sito della nostra banca.

Digitiamo l’indirizzo nel browser oppure seguiamo un collegamento ricevuto tramite messaggio.

La pagina che appare è familiare: stesso logo, stessi colori, stessa disposizione dei pulsanti.

Inseriamo le credenziali.

Eppure qualcosa non torna.

L’indirizzo contiene una piccola differenza rispetto a quello originale: una lettera scambiata, un carattere aggiunto oppure una parola apparentemente innocua.

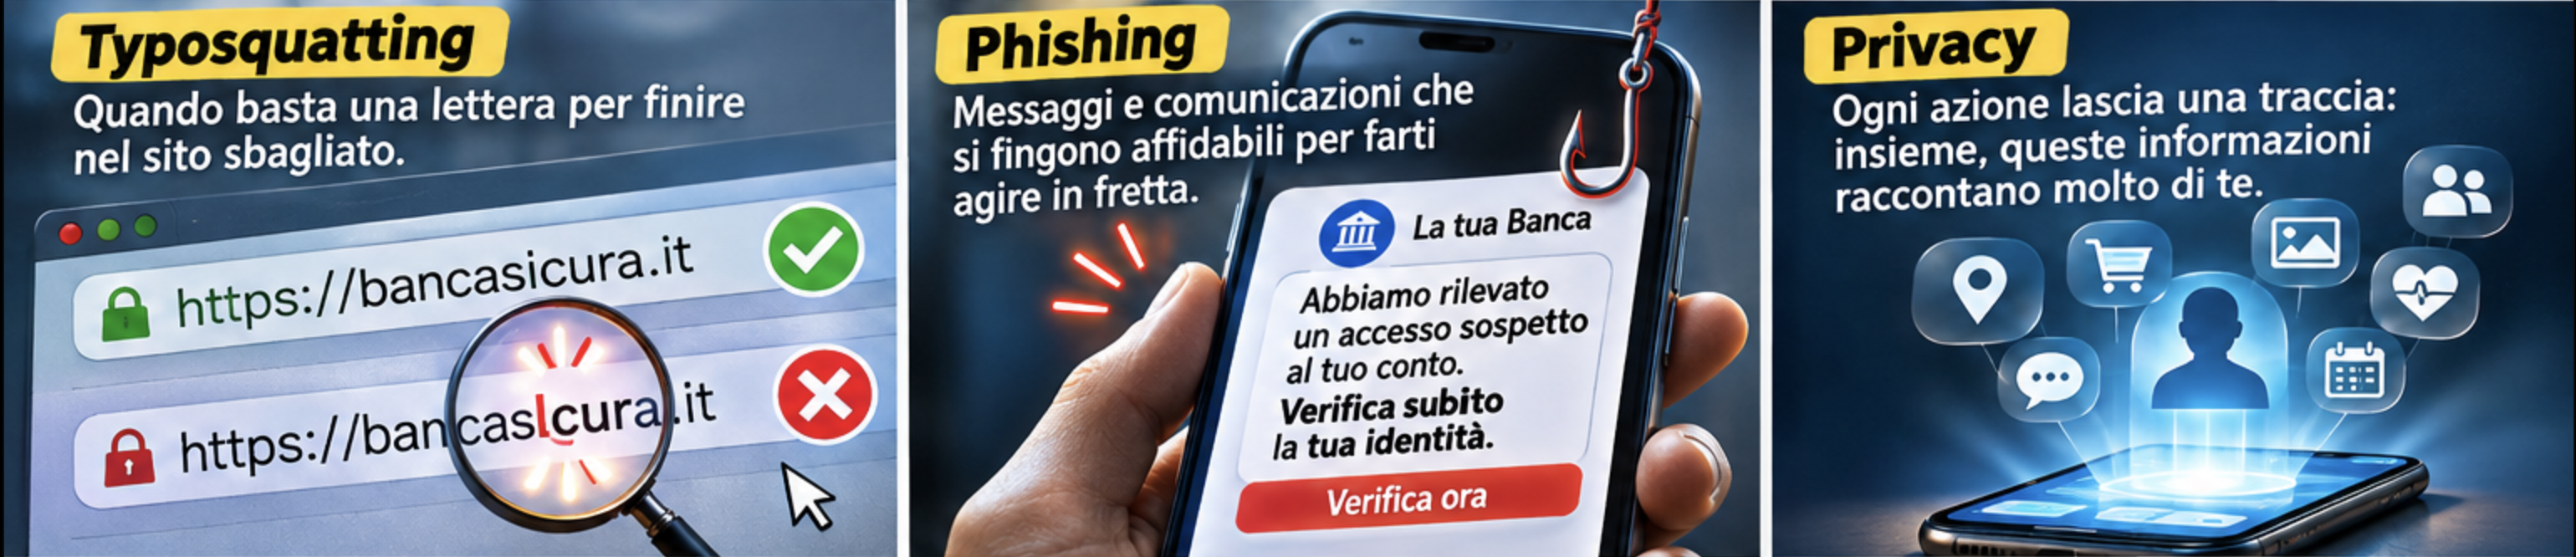
È uno dei meccanismi utilizzati nel typosquatting, una tecnica che sfrutta indirizzi Internet molto simili a quelli autentici.

Per esempio, immaginiamo un servizio fittizio chiamato bancasicura.it. Un malintenzionato potrebbe utilizzare un indirizzo simile come bancaslcura.it, sostituendo una lettera con un’altra graficamente somigliante.

La differenza può essere difficile da notare, soprattutto sul piccolo schermo di uno smartphone.

Il typosquatting non è necessariamente un attacco in sé: è una tecnica di imitazione degli indirizzi che può essere utilizzata per indirizzare le persone verso siti fraudolenti, distribuire software indesiderato o sottrarre informazioni.

E c’è un dettaglio importante: il lucchetto del browser e la presenza di HTTPS non garantiscono che un sito sia legittimo.

Indicano che la connessione è cifrata, non che chi gestisce il sito sia chi dichiara di essere.

La prima difesa non richiede competenze specialistiche: per operazioni delicate, è preferibile utilizzare un’app ufficiale verificata oppure un indirizzo salvato in precedenza e controllare attentamente il dominio prima di inserire informazioni.

È un po’ come leggere un cartello stradale prima di imboccare una direzione.

Un secondo di attenzione può evitare di finire nel posto sbagliato o contromano in autostrada

Il phishing: quando l’attacco arriva travestito da comunicazione

Un messaggio sul telefono:

«Abbiamo rilevato un accesso sospetto al tuo conto. Per evitare la sospensione, verifica immediatamente la tua identità.»

Il messaggio sembra provenire dalla banca. Il tono è professionale. Il logo è quello giusto.

E soprattutto c’è una parola che cambia tutto: immediatamente.

Il phishing è una forma di inganno che tenta di ottenere informazioni, credenziali o azioni attraverso comunicazioni che imitano soggetti affidabili.

Può arrivare tramite email, SMS, applicazioni di messaggistica o altri canali.

Non si basa soltanto sull’imitazione grafica. Sfrutta emozioni e comportamenti umani: urgenza, paura di perdere denaro, curiosità, fiducia nell’autorità.

Il messaggio può parlare di un pacco in consegna, di una fattura non pagata, di un rimborso fiscale, di un account da verificare, di un premio da ritirare.

Ciò che accomuna molti di questi tentativi è la volontà di farci agire prima di riflettere.

E sullo smartphone questo meccanismo può essere particolarmente efficace.

Una notifica compare mentre siamo impegnati in altro; la apriamo, leggiamo velocemente e decidiamo in pochi secondi.

La domanda da porsi non è soltanto:

«Questo messaggio sembra autentico?»

Ma soprattutto:

«Posso verificare questa richiesta attraverso un canale indipendente?»

Se riceviamo una comunicazione apparentemente bancaria, possiamo aprire autonomamente l’app della banca o contattarla attraverso un recapito già conosciuto.

Non dobbiamo necessariamente riconoscere ogni possibile truffa.

Dobbiamo imparare a non affidare la verifica di un messaggio agli stessi strumenti che il messaggio ci propone.

La privacy: quello che lasciamo dietro di noi

Finora abbiamo parlato di attacchi, ma esiste un’altra dimensione della sicurezza digitale, meno evidente e spesso sottovalutata.

La quantità di informazioni che produciamo e condividiamo quotidianamente.

Ogni account creato, ogni applicazione autorizzata, ogni servizio utilizzato può contribuire alla costruzione di un insieme di dati che racconta qualcosa di noi.

Non parliamo soltanto di nome, cognome o indirizzo.

Le nostre abitudini, gli orari, gli spostamenti, gli interessi, gli acquisti e le relazioni possono rivelare aspetti personali anche senza che li abbiamo dichiarati esplicitamente.

Una singola informazione può sembrare insignificante. Molte informazioni, combinate, possono diventare estremamente rivelatrici.

E non serve necessariamente che qualcuno violi il nostro telefono per raccoglierle.

Una parte può essere acquisita attraverso normali attività di tracciamento, autorizzazioni concesse alle applicazioni o servizi a cui abbiamo scelto di affidarci.

Naturalmente, non ogni raccolta di dati è illegittima o malevola. Molti servizi hanno bisogno di determinate informazioni per funzionare.

La questione è un’altra:

Siamo consapevoli di quali dati cediamo, a chi e per quali finalità?

Proteggere la privacy non significa necessariamente diventare invisibili su Internet.

Significa recuperare, per quanto possibile, la capacità di decidere quali informazioni condividere.

E proprio come impariamo a non lasciare incustoditi documenti, chiavi o oggetti di valore, dovremmo imparare a considerare anche le nostre informazioni digitali qualcosa che merita attenzione.

Qui so già che molti penseranno: “ma tanto io non ho nulla da nascondere…”

«Non ho nulla da nascondere» è forse la frase più ingenua che si possa pronunciare nell’era digitale. Perché la privacy non serve a nascondere qualcosa di sbagliato, ma a impedire che qualcuno possa sapere tutto di noi, utilizzare quelle informazioni contro di noi e decidere cosa farne senza il nostro consenso.
Non chiudiamo la porta di casa perché nascondiamo qualcosa di illegale. La chiudiamo perché ciò che è nostro non deve essere automaticamente accessibile a chiunque, senza il nostro consenso.

Perché dovremmo ragionare diversamente con la nostra vita digitale?»

Non serve vivere nella paura

A questo punto qualcuno potrebbe pensare che la soluzione sia rinunciare allo smartphone, smettere di utilizzare Internet o diffidare di qualsiasi servizio.

Non è questo l’obiettivo.

La tecnologia offre opportunità enormi, e sarebbe assurdo ignorarle.

La sicurezza, inoltre, non è uno stato assoluto.

Non esiste un dispositivo, un’applicazione o un comportamento capace di eliminare completamente ogni rischio.

Esistono però abitudini che possono ridurlo considerevolmente.

Imparare a distinguere un indirizzo autentico da uno ingannevole. Non riutilizzare le password. Attivare sistemi di autenticazione aggiuntivi, preferendo quando disponibili passkey resistenti al phishing. Mantenere aggiornati i dispositivi. Limitare i permessi delle applicazioni e cancellare gli account inutilizzati.

Sono comportamenti che non richiedono necessariamente grandi investimenti economici né una formazione informatica avanzata.

Richiedono soprattutto una cosa: comprendere perché sono importanti.

Perché installare un’applicazione di sicurezza senza sapere quali problemi affronta può darci una falsa sensazione di protezione.

E perché nessuna tecnologia può sostituire completamente la nostra capacità di valutare una situazione.

L’obiettivo non è trasformare ogni cittadino in un esperto di cybersecurity. È fare in modo che nessuno debba affidarsi esclusivamente alla fortuna quando utilizza gli strumenti digitali della propria vita quotidiana.

La consapevolezza è il primo sistema di sicurezza

Torniamo per un momento all’automobile.

Oggi saliamo in macchina e diamo per scontato che esistano regole, strumenti e comportamenti pensati per proteggerci.

Sappiamo che una cintura di sicurezza può ridurre le conseguenze di un incidente, che un semaforo rosso impone di fermarsi e che non tutte le condizioni di guida presentano lo stesso livello di rischio.

Eppure non viviamo ogni viaggio con la paura di avere un incidente.

Semplicemente, abbiamo imparato a riconoscere i pericoli e ad adottare comportamenti adeguati.

È questo il rapporto che dovremmo costruire anche con la tecnologia digitale.

Non dobbiamo rinunciare alla comodità dello smartphone, ma smettere di considerare ogni operazione semplice soltanto perché è facile da eseguire.

Un pulsante può essere facile da premere senza che le conseguenze siano altrettanto semplici da comprendere.

Un’applicazione può essere intuitiva senza essere necessariamente rispettosa della nostra privacy.

Un messaggio può sembrare affidabile senza esserlo davvero.

La semplicità di utilizzo non deve essere confusa con l’assenza di rischi.

E forse è proprio questa la prima regola della nostra educazione digitale.

Non avere paura della tecnologia.

Imparare a conoscerla.

Fine della prima parte.

La FIDUCIA è la prima falla di sicurezza

Premessa: il caso emblematico che gira sui forum e sui social in questi giorni è quello riguarda un monitor LG UltraGear di fascia alta e Windows che, senza chiederti nulla, scarica sul tuo PC “LG Monitor App Installer”.


Introduzione

Ogni volta che si parla di sicurezza informatica l’attenzione si
concentra quasi sempre su vulnerabilità software, malware, ransomware
o algoritmi di cifratura.

Eppure chi lavora nel settore sa che il principio fondamentale non è
cambiato da decenni: un sistema è sicuro quanto il suo anello più
debole
.

Nella maggior parte dei casi quell’anello non è una macchina, ma una
persona.

Da Kevin Mitnick fino a Susan “Susy Thunder” Headley, la storia
dell’hacking ha dimostrato che convincere qualcuno a fidarsi è spesso
più semplice che violare direttamente un sistema.

Il social engineering non aggira la sicurezza: sfrutta la fiducia.

Ed è proprio la fiducia il bene più prezioso di qualsiasi infrastruttura
informatica.


Capitolo 1 — La fiducia come infrastruttura invisibile

Esistono meccanismi che utilizziamo ogni giorno senza più metterli in
discussione.

Quando vediamo un certificato HTTPS valido, una firma digitale, Secure
Boot oppure Windows Update, non analizziamo ogni dettaglio tecnico. Ci
fidiamo.

Non si tratta di ingenuità.

È un automatismo costruito in anni di utilizzo corretto.

Ogni infrastruttura moderna vive anche grazie a questi automatismi.


Capitolo 2 — Windows Update: molto più di un aggiornamento

Per chi ha amministrato sistemi Windows, Windows Update non è mai stato
semplicemente un servizio di aggiornamento.

È un canale privilegiato.

Può scaricare codice, sostituire componenti di sistema, installare
driver firmati e riavviare automaticamente una macchina.

In ambienti aziendali questo meccanismo viene spesso gestito attraverso
processi di validazione, gruppi pilota, WSUS o altre piattaforme di
distribuzione centralizzata. Non perché non ci si fidi di Microsoft, ma
perché ogni modifica ad un sistema produttivo richiede controllo.

Quella fiducia ha però sempre avuto un presupposto implicito: quel
canale esiste per distribuire componenti destinati al funzionamento e
alla sicurezza del sistema.


Capitolo 3 — Quando cambia lo scopo del canale

Il recente caso che ha coinvolto Windows Update e un’applicazione
distribuita automaticamente insieme ad una periferica ha acceso un
dibattito che, a mio avviso, è stato affrontato dal punto di vista
sbagliato.

Molti hanno discusso del software distribuito.

Pochi del canale utilizzato.

Il problema non è se quel software fosse legittimo oppure no.

Il problema è aver modificato il significato di un canale che, per
decenni, gli utenti hanno imparato ad associare esclusivamente alla
sicurezza e al corretto funzionamento del sistema operativo.


Capitolo 4 — L’attaccante sfrutta ciò che già esiste

Il social engineering funziona perché sfrutta comportamenti consolidati.

L’attaccante non costruisce una nuova fiducia.

Sfrutta una fiducia che qualcun altro ha impiegato anni a costruire.

È esattamente questo il motivo per cui qualsiasi abuso di un canale
privilegiato rappresenta un rischio.

Ogni eccezione rende più difficile distinguere ciò che appartiene al
normale funzionamento del sistema da ciò che non dovrebbe esserci.


Capitolo 5 — Non riguarda soltanto Windows

Lo stesso principio vale per i repository delle distribuzioni Linux, gli
aggiornamenti OTA degli smartphone, i certificati digitali, le firme
Authenticode, Secure Boot e qualsiasi altro meccanismo che richieda
fiducia preventiva.

La sicurezza di questi sistemi non dipende soltanto dalla loro
robustezza tecnica.

Dipende anche dalla credibilità che riescono a mantenere nel tempo.

Quando quella credibilità viene compromessa, aumenta inevitabilmente
anche la superficie di attacco.


Capitolo 6 — I precedenti insegnano

La storia ci ricorda che casi come Lenovo Superfish, SolarWinds,
CCleaner compromesso e la recente vicenda XZ Utils hanno avuto
caratteristiche tecniche molto diverse.

La vicenda di XZ Utils (CVE-2024-3094) fa riferimento a una grave vulnerabilità di sicurezza informatica scoperta alla fine di marzo del 2024. Si è trattato di un sofisticato attacco alla catena di fornitura (supply chain attack) mirato a inserire una backdoor (una porta di servizio nascosta) all’interno di liblzma, una libreria di compressione dati comunemente integrata nei sistemi operativi Linux e Unix. [1, 2, 3, 4]

Ciò che li accomuna è una lezione fondamentale: quando viene meno la
fiducia nella catena di distribuzione del software, il problema non
riguarda più il singolo prodotto ma l’intero ecosistema.

Per questo motivo ogni modifica alle regole implicite di un canale
privilegiato dovrebbe essere valutata con estrema cautela.


Conclusioni

La sicurezza non consiste soltanto nell’impedire che qualcuno entri.

Consiste nel preservare i motivi per cui continuiamo ad aprire
volontariamente alcune porte.

Un firewall può essere aggiornato.

Una vulnerabilità può essere corretta.

La fiducia, invece, richiede anni per essere costruita e può essere
compromessa da un solo precedente.

Forse è proprio questa la lezione più importante: la sicurezza non è
fatta soltanto di codice, protocolli e algoritmi.

È fatta soprattutto di aspettative.

E nel momento in cui alteriamo le aspettative degli utenti, stiamo
modificando uno degli elementi più delicati dell’intera architettura
della sicurezza.

NixOS e Nix-Bitcoin due rivoluzioni tecnologiche che si uniscono

Nell’articolo di oggi voglio parlare di Nixos, che non è solo una distribuzione Linux, ma è un sistema diverso di usare Linux e che a mio parere porta alcuni vantaggi estremamente importanti. Nixos è un sistema operativo Linux che ha alcune peculiarità che lo rendono particolarmente differente da ciò che già conosciamo ed usiamo.
Nei sistemi operativi Linux, definiamoli “standard” intendendo quelle versioni che esistono da decenni e che si sono fatte una reputazione, come Debian, Ubuntu, Fedora etc… ,  tendiamo ad avere un sistema operativo nel quale possiamo installare applicazioni usando dei comandi da terminale. Su Linux i packet manager, quindi la parte del sistema dedicata a gestire i pacchetti e le applicazioni, più utilizzati sono Apt, Yum, Pacman etc.
Quindi noi per esempio per installare un’app tenderemo ad utilizzare il comando :

# sudo apt install brave
(comando tipico per tutte le versioni Debian derivate per installare per esempio un browser)

Nixos invece funziona in maniera molto diversa. Infatti c’è un sistema operativo di base inalterabile, modificabile solo e soltanto tramite l’uso dell’utenza amministrativa nota come ROOT, senza la quale non potete andare direttamente ad agire sul sistema, tutto viene svolto dalle utenze normali che invece di passare comandi sulla shell possono dire al sistema che cosa installare tramite l’uso di un file di configurazione testuale. Riassumendo (repetita iuvant) noi non andiamo ad installare direttamente delle app dando dei complicati comandi nel terminale, ma abbiamo un file di testo che viene chiamato configuration.nix ; all’interno di questo file di configurazione andiamo a installare applicazioni, andiamo a personalizzare parti del sistema, installare servizi, eccetera eccetera. Detto questo facciamo una piccola overview di cosa è Nixos e perché si distingue dagli altri sistemi operativi in 3 punti principali:
 

  1. Il punto numero Uno è l’astrazione; abbiamo detto che tutti i pacchetti vengono astratti al posto che utilizzare tantissimi comandi dal terminale li definiamo in un file di configurazione, quindi nel sistema i pacchetti sono gestiti, con un file di linguaggio Nix. Es: vogliamo installare Brave, Tor e Telegram, non dobbiamo dare un sacco di comandi a terminale, ci basta aprire semplicemente il file di configurazione, aggiungere una linea con scritto Tor, una linea con scritto Brave, una linea con scritto Telegram, salvarlo, dire “aggiorna” al sistema e quando questo avrà caricato tutti i pacchetti ci troveremo all’interno del nostro sistema operativo tutte queste applicazioni installate. Il sistema inoltre è riproducibile. Cos’è? Cosa significa questo? Vuol dire che se io ho un computer con Nixos e voglio per esempio copiarlo uno a uno su un altro PC, mi basta copiare il file di configurazione da un PC all’altro, dare il comando per fare il build di un nuovo sistema operativo ed otterremo due sistemi operativi di base che sono, tra virgolette, identici e immutabili.
    [Per chiarezza diciamo, cosa che i più esperti e navigati già avranno capito, che NixOS non ha inventato nulla, sistemi per “clonare” i pacchetti già installati su una macchina anche su altre erano già possibili, ma è stato reso più facile e più fruibile l’uso di un metodo di configurazione esportabile che può assomigliare anche ai concetti di Ansible, che rende la gestione di un sistema Linux più accessibile a tante persone che non amano dover continuamente imparare “linguaggi” di programmazione/configurazione di sistemi, che in questo modo diventano solo un’interfaccia di replicazione velocizzando notevolmente i tempi di installazione e configurazione di una nuova macchina, sia essa fisica o virtuale…].  

    Tutte le personalizzazioni sono dunque integrate all’interno del file di configurazione di Nix. Se io lo copio da un computer all’altro, i due PC diventano praticamente identici, quindi installano gli stessi pacchetti, le stesse personalizzazioni dunque diventa molto facile andare a copiare per esempio il nostro computer sul nostro portatile, sul nostro server. Diventa estremamente più semplice fare due macchine identiche e con le stesse proprietà. Nix supporta gli Atomic Upgrade, per dirlo in parole facili, quando voi aggiornate il vostro sistema operativo non si potrà più bloccare con facilità. In poche parole, può capitare, in generale (capita sempre meno , ma può succedere) che quando si fanno importanti aggiornamenti di sistema o si aggiorna il Kernel del sistema operativo…, questo facendo l’upgrade di interi blocchi di librerie, possa andare in conflitto con parti della gestione hardware (molto spesso si hanno problemi con la gestione dei componenti delle schede video a causa di librerie parzialmente open source o proprietarie) dando come esito finale o che il sistema non riesce ad avviarsi o che non riesca a far partire l’interfaccia grafica, perda il punto di accesso dei permessi dell’utente con cui state cercando di collegarvi etc etc…; con gli aggiornamenti atomici invece se c’è qualsiasi tipo di problema, tipo il computer non si avvia, non parte, si corrompono delle funzioni fondamentali di esso; questo torna automaticamente alla versione precedentemente funzionante.
  2. La parte successiva interessante di NixOS è l’immutabilità. Come detto prima, il sistema non può essere modificato e quindi nemmeno, per esempio, potreste fare dei casini accidentalmente oppure a causa di software malevoli. Tranne nei casi in cui DECIDIATE di operare con l’utente ROOT, il sistema è sempre in protezione, fermo e immutabile. Quindi è molto più difficile fare casini all’interno di esso, sia in maniera involontaria che, per esempio, in maniera malevola.
  1. L’ultima parte su cui ci concentriamo è proprio il pacchetto Nix ossia il packet manager di NixOS, quindi l’equivalente di APT su Debian/Ubuntu, il quale ha delle funzionalità in più rispetto agli altri sistemi operativi, a mio parere, molto interessanti. Nix offre aggiornamenti e rollback atomici, più versioni dell’installazione dei pacchetti, gestione dei pacchetti multiutente e configurazione semplice degli ambienti di compilazione per un pacchetto, indipendentemente dai linguaggi di programmazione e dagli strumenti utilizzati dallo sviluppatore.
    Sotto Nix, i pacchetti sono costruiti da un linguaggio di pacchettizzazione, il linguaggio Nix è progettato per creare e comporre comodamente derivazioni : descrizioni precise di come i contenuti dei file esistenti vengono utilizzati per derivare nuovi file. Questo approccio funzionale alla gestione dei pacchetti garantisce che l’installazione o l’aggiornamento di un pacchetto non possa danneggiare altri pacchetti. Nix ha anche il supporto multiutente, il che implica che gli utenti di sistema normali (o non privilegiati) possono installare i pacchetti in modo sicuro e ogni utente è identificato da un profilo (una raccolta di pacchetti nello store Nix che appare nel PERCORSO dell’utente). Nel caso in cui un utente abbia installato un pacchetto, se un altro utente tenta di installare lo stesso pacchetto, il pacchetto non verrà compilato o scaricato una seconda volta.

In più è possibile eventualmente anche utilizzare software e applicazioni senza doverli direttamente installare. Questo, a mio parere, è un vantaggio comodissimo perché, per esempio, se voi state utilizzando Ubuntu e volete provare Electrum, perché non l’avete mai utilizzato, su NixOS potete semplicemente testare, utilizzare un software in maniera temporanea. Quindi lo provo, sia che mi piaccia, non mi piaccia, una volta che chiudo la shell, chiudo il programma, è tutto scomparso. Utilissimo per, per esempio, scoprire un software che non funziona. Invece se dovete utilizzare software che utilizzate soltanto occasionalmente, tipo, non so, balena Hatcher per creare chiavette, un wallet Bitcoin, non dovete per forza tenere tutto installato sul PC, potete anche avviare un programma una sola volta e nel momento in cui lo chiudete tutto dimenticato, tutto pulito. 

NIX-BITCOIN

(https://github.com/fort-nix/nix-bitcoin)
Alcuni sviluppatori di Bitcoin Core, esperti di sicurezza privacy e conoscenze in ambito bitcoin hanno sviluppato questo pacchetto per nixos che si chiama nix-bitcoin ; nix-bitcoin è dunque una raccolta di pacchetti Nix e moduli NixOS per installare facilmente nodi Bitcoin completi, con particolare attenzione alla sicurezza.

nix-bitcoin può essere utilizzato per portafogli personali o commerciali, per infrastrutture pubbliche o per backend di applicazioni Bitcoin. In tutti i casi, l’obiettivo è quello di fornire sicurezza e privacy per impostazione predefinita. Tuttavia, sebbene nix-bitcoin sia oggi già utilizzato in produzione, è ancora considerato sperimentale.

I nodi nix-bitcoin possono essere distribuiti su hardware dedicato, macchine virtuali o container. I pacchetti Nix e i moduli NixOS possono essere utilizzati indipendentemente e combinati liberamente.

nix-bitcoin è costruito sulla base del linguaggio Nix e NixOS, che forniscono potenti astrazioni per mantenerlo altamente personalizzabile e manutenibile. Ne sono testimonianza le robuste funzioni di sicurezza di nix-bitcoin e il suo potente framework di test; inoltre l’esecuzione di nix-bitcoin non richiede alcuna esperienza precedente con l’ecosistema Nix.

Considerando dunque in fine tutti punti trattati a favore di NixOS + NixBitcoin, vale certamente la pena per chi è sempre interessato a nuove possibilità e funzioni di accrescimento delle proprie libertà lavorative e tecnologiche, di fare almeno un test, uno studio a riguardo, per cercare di comprendere i tanti vantaggi che un sistema come NixOS ed il suo linguaggio di programmazione/configurazione, possono dare al miglioramento del tempo di lavoro, sicurezza e scalabilità dei sistemi.

Il web3 è sicuro, se sai quello che fai


Mentre ero affacendato nella preparazione del prossimo articolo su Bitcoin, e tutto il mondo che gli ruota attorno, mi sono imbattuto in un post Linkedin che recitava esattamente “Il web3 è sicuro, se sai quello che fai”.

Questo pensiero mi ha intrattenuto in una serie di pensieri articolati che proverò a sciorinare senza esprimere verdetti ma dando, come sempre, il mio parere personale.

Consapevolezza

I progressi tecnologici diventano veramente di massa nel momento in cui l’avanzamento delle nuove tecnologie si evolve talmente tanto da diventare quasi invisibile per cui il loro utilizzo si trasforma in uno standard in nuova gestualità a cui non dobbiamo più pensare. Oggi quasi chiunque ha familiarità con l’account di posta, con l’uso di diversi tool di messaggistica (su pc e smartphone) o anche l’uso di vari sistemi di pagamento tra carte di credito, pagamenti online o anche tramite App su smartphone e smartwatch.

Molta della tecnologia appena descritta fruisce dalle pagine web dei nostri browser che usiamo per comprare su Amazon, per scrivere messaggi su Whatsapp, per sbrigare una commissione amministrativa sui portali delle Regioni magari usando un sistema SPID e molto altro ancora. A tutto ciò che potremmo includere in quelli che sono ad oggi la base portante dei servizi web online su quello che viene chiamato WEB 2.0 si sono aggiunti e continuano ad aggiungersi nuovi servizi con nuove modalità che sono quelli che appartengono alla galassia del WEB 3.0, tra i quali spiccano certamente in pole-position le crypto, gli nft ed i metaversi.

Ma in molti servizi giornalistici/TG continuano a comparire i rischi di frode dati dalla poca conoscenza delle metodologie migliori per gestire i propri dati personali durante l’uso dei servizi online, per cui filoni come il Phishing sono ancora oggi una delle minacce più importanti per le frodi online, frodi che spaziano dal furto di identità online da rivendere nel DarkWeb fino al furto di username/password per l’accesso a servizi bancari, carte di credito e quant’altro.

Dunque sarebbe logico affermare che ci troviamo ancora in una fase di “studio” da parte della CriticalMass nell’imparare i metodi per un uso consapevole dei mezzi informatici, potremmo paragonarci all’inizio del ‘900 in cui l’uso dell’automobile iniziava a diffondersi ma ancora non esistevano molti sistemi di verifica e controllo per un uso intelligente e consapevole da parte dei neo possessori dell’auto, mancanza di segnaletica stradale, mancanza di semafori per un controllo dei flussi di marcia, mancanza dei sistemi di sicurezza e di divisione stradale tra il flusso dei pedoni e quello dei mezzi a 4 ruote etc…. In tutto ciò stiamo gia vivendo l’affiancamento delle tecnologie appartenenti al WEB 3.0 che porta con se sia la necessità di una maggiore conoscenza e consapevolezza da parte dell’utente ma anche di chi sta creando le nuove applicazioni. Infatti potremmo dire che mai come oggi i TEST ed il DEBUG delle Applicazioni web sono di vitale importanza.

I test sono una parte importante di qualsiasi progetto di sviluppo software, ma si sono rivelati particolarmente cruciali per il successo dei progetti Web3. Mentre con le app Web2 si possono verificare registrazioni errate o pagamenti falliti, i bug introdotti nello sviluppo delle app Web3 possono consentire agli utenti malevoli di sgonfiare il valore di un token coniando token in eccesso, modificare le regole di funzionamento di una DAO o persino congelare in modo permanente i fondi collegati a uno smart contract.

Con i progetti Web2, i bug possono essere risolti con semplici rami di correzione che vengono distribuiti prima che altri dati vengano corrotti o che importanti vendite vadano perse. Questo non è il caso di Web3: i bug in un’applicazione Web3 sono permanenti, poiché qualsiasi smart contract distribuito sulla blockchain è immutabile. Si può trovare una soluzione, ma una volta che il contratto è attivo diventa impossibile implementarla.

Possiamo realisticamente pensare di scrivere codice invulnerabile agli attacchi? L’idea di una sicurezza perfetta, anche nel Web3, è un’aspirazione impossibile ?!. Tuttavia, con test adeguati ed una maggiore conoscenza da parte di tutti gli attori, possiamo ridurre le superfici di attacco per i malintenzionati.

SAFER SMART CONTRACTS

Proverò ora ad introdurre un nuovissimo sistema di TESTING che potrebbe essere di aiuto nella gestione e verifica della stesura degli SmartContracts per Bitcoin, questo strumento si chiama CLARITY.

Clarity porta i contratti intelligenti in Bitcoin usando un linguaggio decidibile (che può essere deciso, cioè risolto, stabilito, determinato), il che significa che si può sapere con certezza dal codice stesso cosa farà il programma. Clarity è interpretato (non compilato) ed il suo codice sorgente è pubblicato sulla blockchain. Clarity offre così agli sviluppatori un modo sicuro per costruire contratti intelligenti complessi per la blockchain più sicura del mondo.

I progetti Clarity vengono creati con Clarinet (clarinet è un runtime di Clarity confezionato come strumento a riga di comando, progettato per facilitare la comprensione, lo sviluppo, il test e la distribuzione dei contratti intelligenti) sono dotati di un framework di test TypeScript integrato. Utilizzando questo framework è possibile distribuire i nostri smart contract su catene di test per eseguire le nostre varie funzioni su di esse. Questo ci permette di simulare funzioni pubbliche e di sola lettura e di verificare come accedono e modificano lo stato della catena.

Conclusioni

Dunque se una maggiore integrazione di sistemi per i test è fondamentale per una buona progettazione Web3, allora conoscere gli strumenti di test migliori è fondamentale per scrivere test ottimi e a copertura totale. Per il momento posso solo consigliare a coloro che sono interessati all’argomento di dare un’occhiata al materiale distribuito sullo spazio Github del progetto:

https://github.com/clarity-lang

FileSystem Decentralizzato – IPFS

Per chi ancora non conosce il progetto IPFS (creato all’interno del MIT di Boston), posso cominciare dando la definizione riportata sulla pagina Wikipedia, ossia che: L’InterPlanetary File System (IPFS) è un protocollo di comunicazione e una rete peer-to-peer per l’archiviazione e la condivisione di dati in un file system distribuito.

IPFS basa il suo funzionamento sull’utilizzo di molteplici tecnologie, racchiudendo in se le più moderne idee alla base di precedenti sistemi peer-to-peer, inclusi DHT, BitTorrent, Git e SFS.

Bene, dopo questa introduzione dobbiamo capire cosa si può già realmente fare con IPFS, poichè essendo un progetto in forte sviluppo, sono già parecchi gli usi pratici su cui potremo inserire IPFS in un nostro progetto.

Ma quella definizione di “Sistema Interplanetario per la gestione dei dati” potrebbe forse farvi comprendere la vicinanza di questo progetto con la blockchain. Infatti quando è nata la tecnologia della Blockchain, il Bitcoin aveva lo scopo di far usare la blockchain per espandere la libertà finanziaria a tutti coloro che avrebbero usato quel sistema. IPFS vuole portare ulteriormente avanti il concetto da cui è nata la blockchain, non a caso, per gli sviluppatori del progetto la stessa blockchain non dovrebbe essere vista legata solamente alle transazioni di denaro (immagine che attualmente è stata appiccicata a questa fantastica tecnologia ), ma bensì dovrebbe rappresentare la nuova infrastruttura di Internet.

In pratica, Internet, così come lo conosciamo oggi, non dovrà più essere il sistema a cui noi semplicemente accediamo, e di cui qualcun’altro possiede l’infrastruttura.

Proviamo a fare un esempio che possa essere chiaro per tutti:

Oggi quando cerchiamo Facebook sul motore di Google, stiamo compiendo le seguenti azioni

Chiediamo a Google di cercare Facebook, per poi

Chiedere a Facebook di mostrarci che cosa fanno i nostri contatti

..tutto ciò senza considerare tutti i passaggi intermedi che ci servono per arrivare su Google e successivamente arrivare a Facebook, ad iniziare dalla prima "request" che viene fatta dal nostro device al nostro gestore di connessione, che sia il provider che ci fornisce la linea di casa o l’operatore telefonico che ci fornisce la rete per navigare.

Passaggi nei quali lasciamo in rete un sacco di tracce, dal nostro indirizzo IP, il nostro indirizzo MAC(ossia l’identificatore unico e univoco del nostro dispositivo connesso in rete), la localizzazione geografica della nostra posizione in tempo reale, la versione di Browser che stiamo utilizzando, fino alla stringa di ricerca che vogliamo venga esaudita. Insomma un bel pò di dati per una semplice ricerca.

Consideriamo adesso che tutte le aziende attraverso cui passano i nostri dati di navigazione, possono leggere e dunque sfruttare tutte queste informazioni per capire come ci comportiamo in rete, cosa siamo soliti cercare, se siamo appassionati di viaggi o di informatica, se abbiamo preferenze verso certi prodotti piuttosto che altri, e molto altro ancora, una vera e propria profilazione.

Ma una profilazione non serve solo come agglomerato di dettagli e specifiche di un’ utente, vendute agli inserzionisti per creare una pubblicità su misura per ogni singolo internauta. Una profilazione di questo tipo identifica una specifica persona meglio delle sedute dallo psicanalista, e non serve usare il concetto di coloro che sono soliti dire: "ma io non ho nulla da nascondere", in quanto il concetto di Privacy non nasce per difendere coloro che hanno qualcosa da nascondere. Immaginate di diventare dei VIP e che improvvisamente stuoli di giornalisti e paparazzi si piazzino davanti a casa vostra, cercando di rubare un momento qualunque della vostra vita, fotografandovi ovunque voi siate……, credo che invochereste il diritto di privacy immediatamente, non perchè abbiate qualcosa da nascondere, ma perchè avete una vostra vita da vivere; allora immaginiamo questi "scrutatori" della vostra vita, come costantemente parcheggiati nel vialetto davanti alla vostra stradina per navigare in Internet. Appena vi collegate, per un qualunque motivo, loro sono già li tutti pronti a scattare foto di ogni attimo della vostra navigazione, che sia per lavoro o per svago.

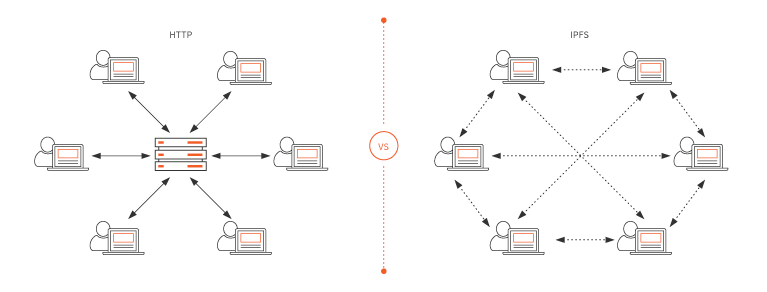
Adesso immaginiamo come potrebbe essere la stessa esperienza se non ci fosse bisogno di "Internet, per accedere ad Internet", questo è quello che stanno cercando di realizzare con IPFS, costruendo un protocollo di navigazione che sostituisca HTTP/S, ormai vecchio, accroccato e che non riesce più a stare al passo con la costante crescita delle innovazioni del WEB. Tenendo anche presente che l’http/s è un protocollo di livello 4, mentre nella pila (ISO/OSI) dei protocolli di rete ci sono ben 7 livelli.

IPFS vuole dunque cambiare il protocollo standard da https:// a ipfs:// , che può sembrare una cosa insignificante, invece tutto questo cambia moltissimo l’uso della rete per ogni utente, perchè con IPFS quando richiediamo un’informazione in rete , non la stiamo più chiedendo ad un insieme di server, sparsi chissà dove nel mondo, e di proprietà di una Big Corporation, ma lo stiamo chiedendo a qualcuno che si trova vicino a noi e che condivide quella informazione, nello spirito dei sistemi peer-to-peer.

Oggi il web è fondamentalmente inefficiente e costoso perché internet costa in ogni suo singolo aspetto, dalla connessione, alle infrastrutture per i servizi che si appoggiano, tutti, troppo, alle infrastrutture GAFA (Google, Amazon, Facebook, Microsoft), di conseguenza, non è possibile immaginare l’attuale Internet come il luogo che preserverà la storia umana.

I vantaggi che si potrebbero trarre dall’utilizzo di IPFS sarebbero molteplici, ad esempio:

• download più veloci ed efficienti: mentre HTTP può scaricare una risorsa da un solo computer alla volta, IPFS pu`o recuperare parti diverse di un file da molteplici computer contemporaneamente;

• un web più robusto: l’architettura di IPFS elimina i server centrali che rappresentano un single point of failure permettendo la creazione di un Web “permanente”. IPFS crea una rete resiliente dove ogni risorsa è sempre disponibile grazie al mirroring dei dati su più nodi;

• resistenza alla censura: mentre può essere molto semplice per un governo bloccare l’accesso a un determinato sito internet ospitato presso un server centralizzato, IPFS crea un Web immune alla censura.

Wikipedia è stato uno dei primi progetti ad essere stato “portato” su IPFS con un progetto che si chiama Distributed Wikipedia.

Dunque come iniziato ad accennare all’inizio dell’articolo, <u>IPFS è un sistema distribuito per l’archiviazione e l’accesso a file, siti Web, applicazioni e dati</u>.

Questo, in soldoni, significa che potrai archiviare qualsiasi tipo di dato/file in IPFS e, dopo averli archiviati, IPFS fornirà un hash che inizia con Qm. Si potrà quindi accedere ai dati usando quell’hash.

HASH

Che cosa sono e quale scopo hanno gli hash ?

L’hash in termini tecnici è noto come Identificatore di contenuto (CID) in IPFS. Il CID è sostanzialmente un’etichetta utilizzata per indicare il contenuto in IPFS, ma non indica dove è archiviato il contenuto. L’hash crittografico del contenuto viene quindi utilizzato per generare CID. L’hash corrisponde a un multihash di caratteri che inizierà con “Qm”. Le lettere “Qm” definiscono l’algoritmo (SHA-256) e la lunghezza (byte 32) utilizzati da IPFS.

Gli hash sono funzioni che accettano input arbitrari e restituiscono un valore di lunghezza fissa. Essi possono essere rappresentati in diverse basi (base2, base16, base32, ecc…).

Caratteristiche degli hash crittografici:

  1. Deterministico
  2. Non correlato
  3. Unico
  4. Senso unico

L’utilizzo dell’hash come chiave per l’identificazione dei file ha inoltre il vantaggio di garantirne l’integrità, poichè, così facendo, il nodo che ha richiesto una risorsa, per assicurarsi che il file ottenuto sia effettivamente quello richiesto e che non abbia subito alcuna alterazione, non dovrà far altro che ricalcolarne l’hash e verificare che questo corrisponda con quello che aveva inizialmente richiesto. Oltre ad aggiungere questa misura di sicurezza gratuitamente, la scelta di utilizzare l’hash come chiave porta un secondo vantaggio, ovvero la deduplicazione dei file: ogni volta che un utente pubblica un nuovo file su IPFS, la rete verifica attraverso il suo hash se questo è già presente, evitando automaticamente che ne vengano mantenute molteplici copie qualora più utenti caricassero la medesima risorsa.

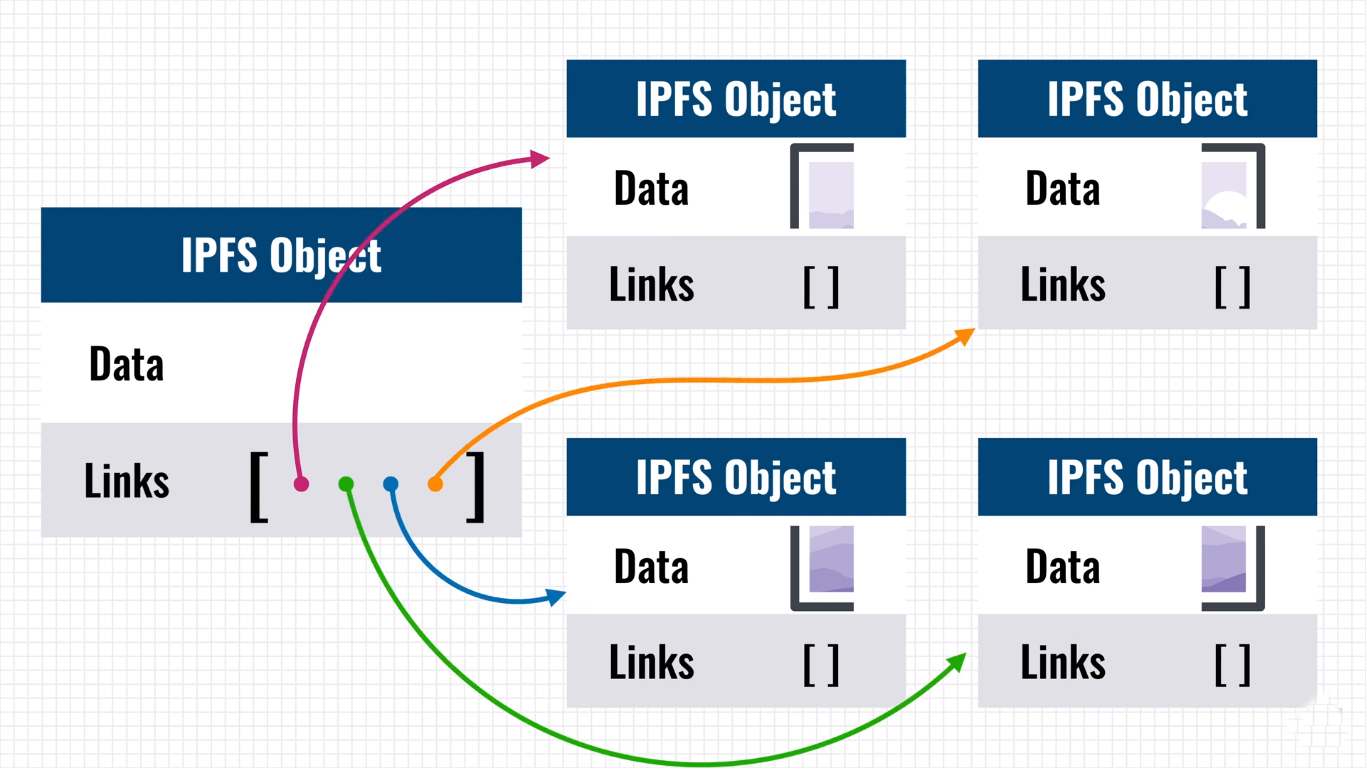
Dal momento che IPFS utilizza l’indirizzamento basato sul contenuto, i file memorizzati su di esso non possono più essere modificati, infatti qualunque aggiornamento al file produrrebbe anche una modifica dell’hash che lo identifica. Per questa ragione IPFS, esattamente come Git, supporta il versioning dei file. Ogni volta che il contenuto di un file viene aggiornato, IPFS crea un oggetto chiamato commit che rappresenta un particolare snapshot nella cronologia delle versioni di un determinato IPFS object. Ogni commit contiene un riferimento al commit precedente e un link alla specifica versione dell’IPFS object (vedi immagine). IPFS tiene traccia in questo modo dell’ultima versione del file e di tutte le versioni precedenti.

SALVARE I DATI

pinning

Ora, una volta spiegato cosa c’è alla base del progetto IPFS, dobbiamo chiarire alcuni punti importanti. IPFS usa lo slogan per cui ciò che SALVI sul sistema rimarrà li per sempre….. SI & NO. La precisazione va ben fatta perchè, facciamo un esempio: Qualche giorno fa abbiamo assistito ad un service-down da parte di Google, che ha precluso l’accesso ai dati personali e lavorativi di milioni di persone, le quali improvvisamente, non riuscivano più ad accedere all’account Gmail, ai dati (privati e di lavoro) su Google Drive etc…. (e la lista è lunga). Pensiamo ai danno provocati da questo “blackout informatico”. Tutto ciò non sarebbe accaduto se i dati a cui noi volevamo attingere fossero stati già salvati su IPFS perchè non dipendono dai servizi e dalle architetture di un’azienda, per grande che sia, ma sono attivi perchè condivisi e replicati da tutti i pc degli utenti che utilizzano questo sistema/protocollo. Quindi se io salvo in rete un documento, questo sarà accessibile fino a quando ci sarà anche solo 1 pc nella rete IPFS in grado di condividermelo. Seppur banalizzato, il concetto è questo ma, non tutto ciò che possiamo caricare su IPFS rimane in eterno, questo perchè non ci serve mantenere ogni cosa, quindi esiste un processo, il PINNING, che ci permette di dire alla rete quali file noi consideriamo IMPORTANTI e vogliamo vengano mantenuti, altrimenti IPFS ha un suo sistema di pulizia della cache per cui, tutto ciò che non è stato “pinnato” verrà svuotato. Un pò come il garbage collector.

PROBLEMA

Chiaramente nessun sistema è perfetto, dunque anche IPFS, seppur abbia ottimi punti di partenza e di futuro sviluppo, ha anch’esso alcuni aspetti problematici da tenere presente, ma così come la Blockchain ha creato i Bitcoin come sistema di INCENTIVAZIONE per poter far crescere l’uso della sua innovazione, così anche IPFS ha dovuto trovare la soluzione per lo stesso dilemma.

Infatti, il problema principale di IPFS è quello di riuscire a mantenere i file sempre disponibili, poichè se un file è condiviso da pochi nodi della rete questo diventerà non disponibile non appena questi nodi andranno offline, esattamente come capita su BitTorrent per i file con pochi seeders. L’unico modo per risolvere questo problema è offrire un incentivo ai nodi per rimanere online quanto più tempo possibile e distribuire così proattivamente i file sulla rete in modo che ci sia sempre un certo numero minimo garantito di nodi, che ne mantenga una copia disponibile.

SOLUZIONE

Per questo gli stessi sviluppatori di IPFS hanno creato il progetto Filecoin, una blockchain basata su IPFS che punta alla creazione di un mercato decentralizzato per lo storage di dati. In questo modo chi offre il proprio spazio di archiviazione per il salvataggio di dati su IPFS è al tempo stesso incentivato economicamente a farlo e a mantenere il proprio nodo online per quanto più tempo possibile. In pratica come Bitcoin per la Blockchain.

Di Filecoin parleremo approfonditamente in un prossimo articolo.

IPNS

L’IPNS, ossia Inter-Planetary Name System è la parte tecnologica di IPFS che possiamo associare a ciò che noi conosciamo sulla internet, basata sul protocollo HTTP, come il servizio DNS, tramite il quale possiamo navigare, grazie alla traduzione da indirizzo-IP basato su numeri, a sequenza ordinata di lettere che compongono gli URL che utilizziamo ogni giorno.

Secondo la documentazione ufficiale di IPFS:

” l’ IPNS è un sistema per la creazione e l’aggiornamento di collegamenti mutabili al contenuto IPFS. Poiché gli oggetti in IPFS sono indirizzati al contenuto, il loro indirizzo cambia ogni volta che il loro contenuto lo fa. È utile per una varietà di cose, ma rende difficile ottenere l’ultima versione di qualcosa.”

Quindi, un nome gestito su IPNS equivale all’hash di una chiave pubblica, ed è associato a un record contenente informazioni sull’hash a cui è collegato, che è firmato dalla chiave privata corrispondente. Chiaramente tutti i nuovi record possono essere firmati e pubblicati in qualsiasi momento.

OGNI COSA HA BISOGNO DEL PROPRIO ATTREZZO

Come ho carcato di spiegare (data la vastità dell’argomento) , IPFS può rendervi indipendenti dall’Internet tradizionale, infatti posso salvalre file, pubblicare un sito ed altro ancora, senza dover usare Google, un DNS, o avere un dominio comprato su un ISP……, già dimenticavo di dire che, così come oggi siamo abitutati a comprare e registrare un dominio per il nostro sito, la stessa cosa la possiamo fare in modo indipendente anche su IPFS, tramite ENS (Ethereum Name Service).

In questo caso possiamo vedere come due tecnologie, simili nei concetti, si possono unire, ed è il caso proprio di IPFS+ENS.

L’ Ethereum Name Service (ENS) è definito come un “sistema di denominazione distribuito, aperto ed estensibile basato sulla blockchain di Ethereum”. Ethereum, per coloro che non lo sapessero, è una piattaforma di contratto intelligente (una blockchain) che vanta un gran numero di applicazioni decentralizzate (dapps), una vivace community di sviluppatori e una dichiarata community di utenti.

ENS è stato progettato per creare un sistema simile al DNS, tuttavia, a causa della diversa architettura decentralizzata di Ethereum, l’ENS varia dalla struttura sfruttata nei sistemi DNS. Tuttavia, proprio come il DNS, l’ENS detiene un record di nomi gerarchici separati da punti chiamati domini, con il proprietario del dominio di primo livello che ha il pieno controllo sui sottodomini.

Ad esempio, se “tizio” possiede il dominio “soldiapalate.eth”, può creare “blog.soldiapalate.eth” e configurarlo come desidera.

Per gli utenti della rete principale di Ethereum, l’ENS semplifica decisamente le cose, inquanto migliora l’usabilità delle dapps restituendo, attraverso la risoluzione inversa, nomi leggibili dall’uomo invece dei lunghi hash di IPFS.

WEB 3.0

Come stavo chiarendo qui sopra, posso essere indipendente da tutto se voglio usare IPFS come sistema di backup/scambio di file ma, cosa succede se voglio usare queste nuove tecnologie per creare un sito web?. Da questi ragionamenti è nato quello che oggi è il web3, che accomuna sistemi decentralizzati come IPFS alle Blockchain, come Ethereum, ma non solo. Infatti, seppur abbiamo chiarito che IPFS funziona, a livello concettuale com Torrent, se i contenuti che voglio condividere sono presenti solo su un computer e quel computer, per qualsiasi motivo, non è disponibile, quei contenuti saranno irragingibili.

Per questo motivo, da qualche tempo per IPFS esistono anche dei servizi di pinning: che ci aiutano a garantire la disponibilità dei nostri contenuti. Tra questi, alcuni nomi sono quelli di Pinata, Infura ed anche il blasonato Cloudflare ha aggiunto tra i suoi servizi quelli di “Gateway Website for IPFS” …… and more.

Il vantaggio del Web 3.0 è che i dati sono distribuiti punto a punto, quindi non è necessario preoccuparsi di perdere i dati se i server sulla rete vengono interrotti. Non è lo stesso di un Web centralizzato, quando il server di accesso viene interrotto, non è possibile accedere al sito Web.

CONCLUSIONE

Per questo primo articolo introduttivo è tutto, nel prossimo inizieremo ad affrontare alcuni casi pratici per vedere come si salvano i dati, li si recuperino in caso di cancellazione, vedremo come attivare un nostro nodo locale e come accedere alla Dashboard di gestione del nodo, e come usare alcuni dei servizi di gateway per velocizzare e gestire il pinning dei dile importanti.

Alla prossima !!

IPFS – Filesystem distribuito